작업 기간: 2026.11.12–11.12
저는 AI와 나눈 대화를 매일 위키로 정리하고, 그 위키가 쓸 만한지 시험으로 재요. 위키만 읽은 AI에게 제 프로젝트의 지금 상태와 기준을 묻고, 답에 요점이 얼마나 들어 있는지 채점하는 시험이에요. 11월 12일에는 이 시험을 하루에 두 번 돌렸고, 저는 단계마다 진행과 머지를 정했어요.
이 글은 위키보다 시험을 먼저 고친 하루에 대한 기록이에요. 점수가 움직였을 때 무엇부터 의심해야 하는지, 그리고 출제 방식이 바뀐 점수를 어떻게 읽어야 하는지에 답해 보려고 해요.
다시 줄인 위키를 처음 잰 중간 시험은 47.3%였어요
11월 3일 첫 시험은 23문항이었고 요점 점수는 38.9%였어요. 23문항 중 14개가 틀림이나 오래됨 판정을 받았고, 답 하나를 내려고 읽은 양은 평균 71.7KB였어요. 그 뒤 지난 199일치 요약을 다시 줄여서, 8KB를 넘던 요약 페이지 104장이 1장으로 줄었어요.
문제는 38.9%가 다시 줄이기 전에 잰 값이라는 점이었어요. 그 무렵 저는 위키의 성공 기준을 요점 점수 70% 이상, 틀림·오래됨 25% 이하, 읽는 양 25KB 이하로 잡았어요. 목표는 잠정이었고, 지금 위키가 그 기준에서 어디쯤인지 말할 숫자가 없었어요.
Claude는 남은 일을 다섯 묶음으로 정리하면서 중간 시험과 오답 원인 분석을 맨 앞에 두었어요. 오답 원인에 따라 목차 줄이기와 프로젝트 이름 정리에서 무엇을 고칠지가 달라진다는 이유였어요. 저는 그 순서대로 계획서를 쓰게 했고, 무거운 실행은 Codex에 넘기기로 했어요.
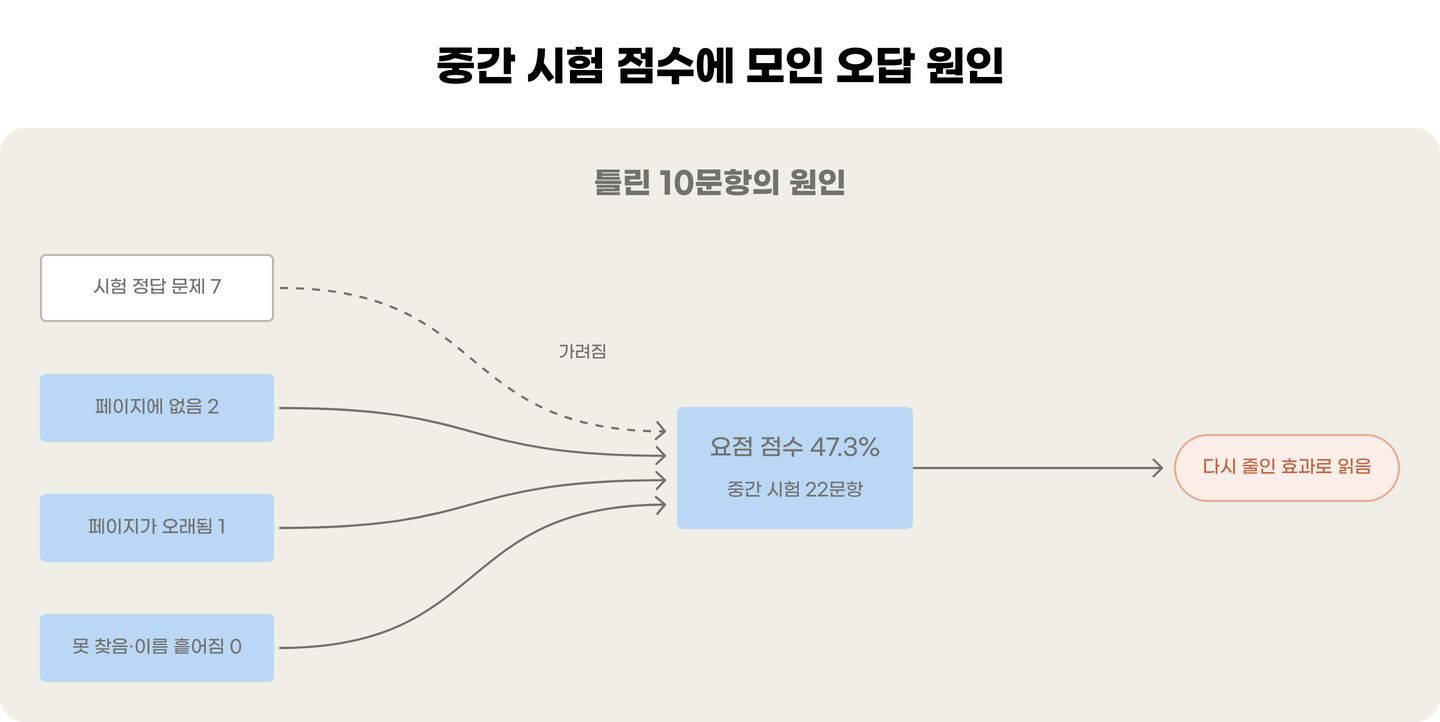
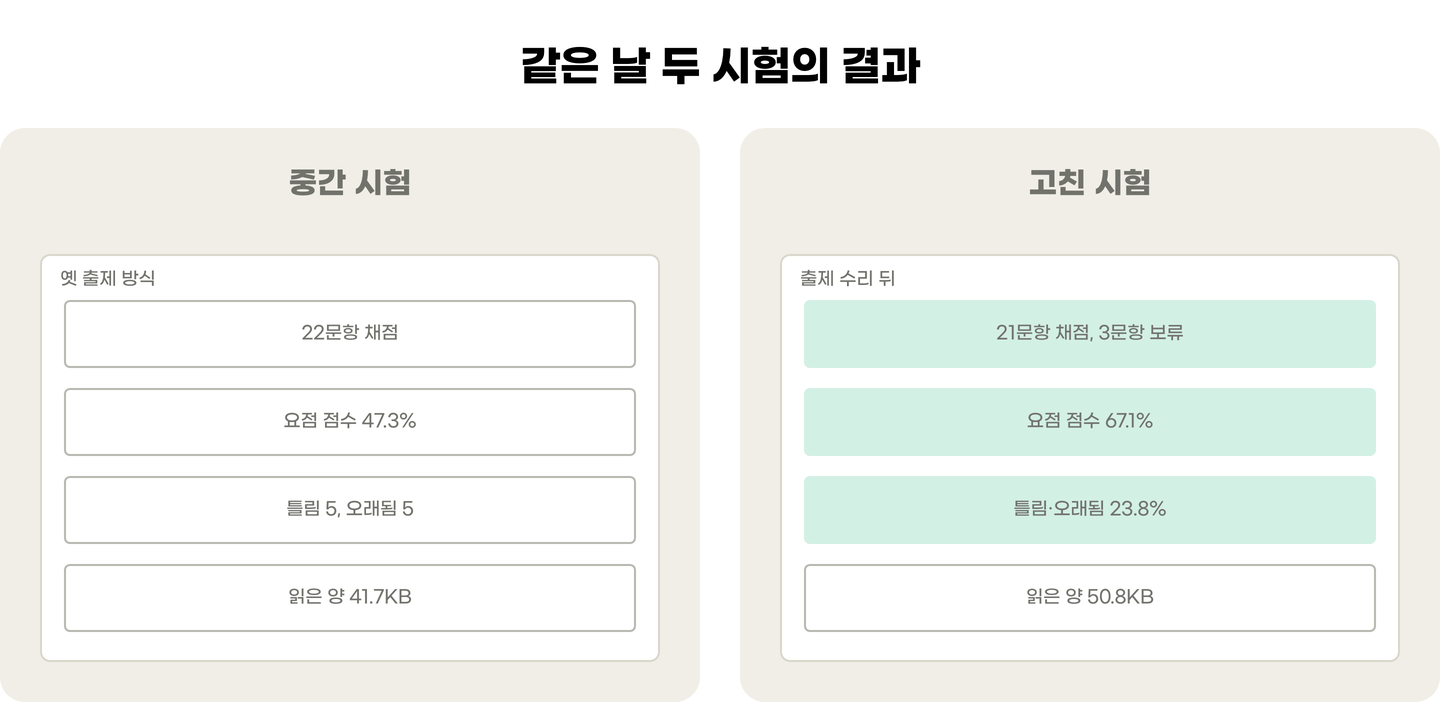
Codex가 돌린 중간 시험은 12시 54분에 끝났어요. 24문항 중 22문항이 답과 채점을 마쳤고, 요점 점수는 47.3%였어요. 판정은 맞음 12, 오래됨 5, 틀림 5였어요. 나머지 2문항은 답변 단계의 10분 제한에 걸려 점수에서 빠졌어요.
38.9%에서 47.3%로 올랐으니, 저는 이 차이를 다시 줄인 효과로 읽고 싶었어요. 같은 프로젝트끼리만 견줘도 요점 점수는 40.6%에서 48.4%로 올라 있었어요. 하지만 Codex는 두 시험의 문항이 달라 개선이라고 단정할 수 없다고 적었고, Claude도 같은 판단이었어요.
그래서 점수보다 틀린 문항을 먼저 봤어요. 계획서에는 틀린 문항을 모두 원인 여섯 가지 중 하나로 나누는 것을 이 묶음의 합격 기준으로 적어 두었어요. 페이지에 없음, 페이지가 오래됨, 못 찾음, 이름 흩어짐, 시험 정답 문제, 기타예요.
틀린 10문항 중 7개는 시험 정답의 결함이었어요
원인 분석은 13시 8분에 끝났어요. 틀림·오래됨이거나 요점이 절반 아래인 10문항을 나눴더니, 시험 정답의 문제가 7건이었어요. 페이지에 없음이 2건, 페이지가 오래됨이 1건이었고, 못 찾음과 이름 흩어짐은 0건이었어요.
결함은 출제 쪽에 있었어요. 시험은 대화 기록을 골라 정답을 만드는데, 대화 번호 앞 8자리만으로 기록을 고르는 코드 때문에 다른 프로젝트 대화가 섞인 문항이 2건이었어요. 질문의 기준 시점과 정답의 기준일이 어긋난 문항도 2건이었어요.
자료가 부족한 문항도 그대로 채점됐어요. 후보 원문 13개가 1개로 줄어든 자료를 프로젝트 전체의 정답으로 삼은 경우가 2건이었어요. 나머지 1건은 이미 끝난 일회성 정리 요청을 지금도 지켜야 할 기준으로 채점한 문항이었어요.
Claude는 보고 첫머리에 틀린 문항의 70%가 시험 문제의 결함이었다고 적었어요. 47.3%는 실제보다 낮게 나온 값일 가능성이 크지만, 얼마나 낮은지는 시험을 고쳐 다시 재야 안다는 단서도 함께 있었어요.
목차와 이름은 정확도를 올릴 수단에서 뺐어요
원인을 세기 전에는 목차를 줄이고 프로젝트 이름을 정리하는 일이 정확도를 올릴 수단으로 계획서에 있었어요. 목차 파일만 18.6KB였고, 같은 프로젝트가 여러 이름으로 기록돼 페이지가 흩어진다고 봤거든요.
원인 분석은 이 가설을 받쳐 주지 않았어요. 못 찾음과 이름 흩어짐이 0건이었으니, 목차와 이름을 고쳐도 이번에 틀린 문항은 맞지 않아요. 그래서 둘 다 정확도를 올리는 수단에서 뺐어요.
목차 줄이기는 다른 이유로 남겼어요. 답할 때마다 목차와 규칙 파일을 읽어서, 이대로는 읽는 양 25KB 기준을 통과할 수 없었어요. 목차를 18,582B에서 7,371B로 줄이는 변경은 읽는 양을 맞추는 용도로만 진행했어요.
이름 정리도 순서를 바꿨어요. Codex는 이름 표를 적용하기 전에 시험이 원문을 프로젝트에 잘못 잇는 문제부터 고치자는 수정안을 냈어요. 이름을 합쳐도 출제가 엉뚱한 대화를 고르면 소용이 없어서예요. 저는 이 수정안을 반영하라고 했어요.
시험을 고치는 변경도 첫 검토에서 세 건이 걸렸어요
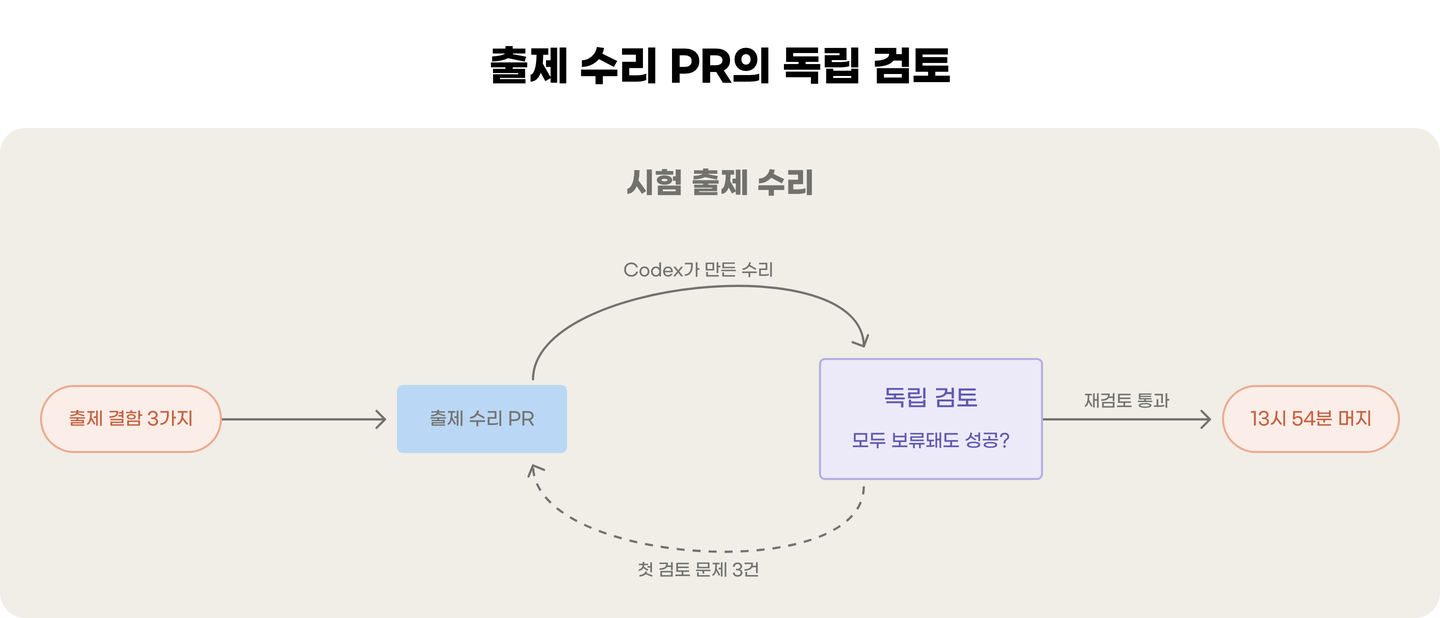
분석 보고서는 대화를 날짜·도구·전체 번호로 잇고, 애매하면 빼라고 권했어요. Codex는 이 권고를 바탕으로 출제 결함을 고치는 PR을 만들었어요. 이 PR은 작성한 실행과 분리된 다른 Codex 실행이 먼저 검토했어요.
첫 검토가 문제 3건을 찾았어요. 민감한 경로를 막는 검사보다 저장된 답을 먼저 읽는 순서가 다시 어긋났고, 빈 문항이 0점으로 섞여 기존 점수 칸이 왜곡됐어요. 가장 위험한 것은 모든 문항이 보류돼도 월간 시험이 성공으로 끝나는 경로였어요.
출제를 고치면서 보류라는 길을 새로 냈는데, 그 길이 시험 전체를 통과시키는 구멍이 될 뻔했어요. Codex가 세 건을 고쳤고, 또 다른 실행이 재검토해 남은 문제 없음으로 판정했어요. Claude가 관련 테스트 188개를 직접 돌려 통과를 확인한 뒤 13시 54분에 머지했어요.
같은 날 같은 위키로 다시 재니 67.1%였어요
고친 시험을 언제 돌릴지는 제가 정할 일이었어요. 계획서에는 모델을 부르는 시험을 두 번만 돌리기로 적었고, 그중 한 번을 이미 썼어요. Claude는 위키 수리를 적용하기 전에 제대로 된 기준 점수를 남겨 두자며 지금 돌리기를 추천했어요.
그사이 Codex 주간 사용량이 82%가 되어, 80%를 넘으면 멈춘다는 계획서 규칙대로 실행이 멈춰 있었어요. 저는 95%까지 계속하는 안을 골랐어요. 고친 시험으로 기준 점수를 재는 일이 그 안에 들어 있었어요.
14시 35분에 결과가 나왔어요. 24문항 중 자료가 충분한 21문항을 채점했고, 요점 점수는 67.1%였어요. 틀림·오래됨은 21문항 중 5개로 23.8%였고, 요점을 전부 맞힌 문항은 14.3%였어요.
같은 날 같은 위키에서 47.3%가 67.1%가 됐어요. Claude는 위키가 좋아져서가 아니라 시험이 제대로 재기 시작했기 때문이라고 읽었고, 오전의 원인 분석과도 맞아떨어졌어요. 틀림·오래됨 비율은 목표 25% 안에 들어왔고, 요점 점수는 목표 70%에 3점 모자랐어요.
대신 읽은 양의 중앙값은 50.8KB로 목표 25KB의 두 배였어요. 중간 시험 분석에서는 답할 때마다 14KB짜리 규칙 파일을 읽고, 절반쯤은 11KB짜리 운영 목차까지 읽었어요. 줄인 목차는 다음 날 새벽부터 적용될 예정이라 이번 시험에는 반영되지 않았어요.
67.1%를 앞의 두 숫자와 나란히 놓지 않았어요
38.9%, 47.3%, 67.1%를 한 줄로 놓으면 위키가 두 번에 걸쳐 크게 나아진 것처럼 보여요. 그런데 셋째 숫자는 출제 방식이 다른 시험에서 나왔어요. 그래서 평가 문서에는 앞의 두 숫자와 직접 비교하지 않는다고 적었어요.
이 숫자의 한계도 같이 적었어요. 보류된 3문항이 무엇이었는지는 따로 보지 않았고, 시험을 한 번만 돌려서 몇 점 차이는 우연일 수 있어요. 읽은 양이 중간 시험의 41.7KB보다 늘어난 이유도 확인하지 못했어요.
그 대신 67.1%를 앞으로의 비교 기준으로 정했어요. 그날 오후에는 규칙 파일을 읽는 법과 쓰는 법으로 나누는 변경까지 적용했고, 그 뒤의 재시험은 이 숫자와만 견줘요. 남은 숙제도 정확도보다 읽는 양 쪽으로 옮겨 갔어요.
제가 정한 것과 AI가 한 것
제가 한 일은 순서와 멈춤을 정하는 것이었어요. 중간 시험을 먼저 돌리는 계획을 받아들였고, 원인 분석에 따른 계획 수정안을 반영하게 했어요. 시험 수리 PR의 머지를 승인했고, 사용량이 82%에 닿았을 때 95%까지 계속하기로 했어요.
Claude는 계획서와 Codex 지시문을 쓰고, 결과를 검토해 보고했어요. 테스트를 직접 돌려 확인한 것과 Codex 보고로만 받은 것을 나눠 적었어요. Codex는 시험을 돌리고 오답을 원인별로 나눴고, 수리 PR을 만들었어요. 다른 Codex 실행은 그 PR을 독립 검토했어요.
처음 질문으로 돌아가면
점수가 움직였을 때 제가 먼저 본 것은 위키가 아닌 틀린 문항이었어요. 원인별로 세어 보니 고칠 곳은 위키보다 시험 쪽에 더 많았고, 목차와 이름은 정확도를 올릴 수단이 되지 못했어요.
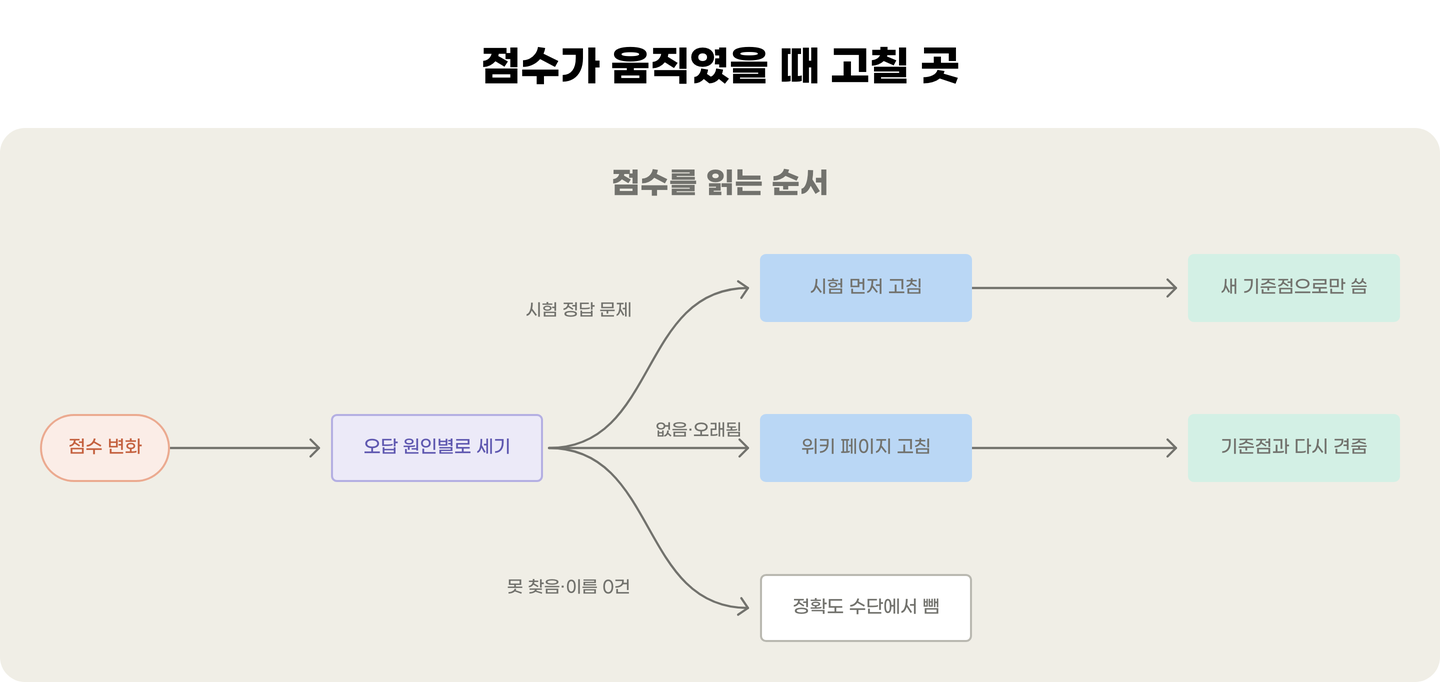
출제 방식이 바뀐 점수는 새 기준점으로만 써요. 숫자가 커 보여도, 같은 자로 잰 숫자끼리만 견줄 수 있어요.
점수가 움직이면 위키보다 시험을 먼저 보고, 오답을 원인별로 센 다음에 고칠 곳을 정해요.